SVM(线性模型)数学推导

作者:zihuanqiu
1590504502746

学习路线:先线性二分类解释清楚,再加入核方法扩展至非线性二分类

几个重要的概念

  1. 训练样本集

    (xi,yi)(\boldsymbol{x}_i,y_i),其中xi\boldsymbol{x_i}为nn维列向量,表示nn维特征;yiy_i为标签,当yi=+1y_i=+1时为正样本,yi=−1y_i=-1时为负样本。

    则训练样本集为:D={(x1,y1),(x2,y2),⋯ ,(xm,ym)},y∈{−1,+1}D=\left\{\left(\boldsymbol{x}_{\boldsymbol{1}},y_1 \right),\left(\boldsymbol{x}_2,y_2\right),\cdots,\left(\boldsymbol{x}_m,y_m\right)\right\},y\in\left\{-1,+1\right\}

  2. 什么叫超平面

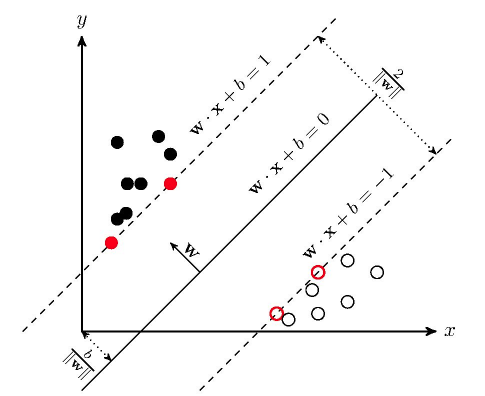
    如上图,若在二维空间内(两个特征),若数据为线性可分,则可以用一条直线将正负样本区分开来(2分类问题);若在三维空间则为一个平面;三维空间以上无法想象统称为超平面。

    但上图中区分正负样本肯定又不止一种划分方法,何者为最优?最优者才叫做SVM的超平面。

    最优的判断标准则是,若对数据样本加以扰动(可以理解为采样样本总有误差),那么SVM超平面具有最佳的鲁棒性。从几何上来看,在上图中,若将超平面左右平移,直至触碰到最近的样本,那么这个被界定的范围记为dd,则SVM的超平面是有最大dd的那个超平面。

  3. 什么叫支持向量

    SVM超平面左右平移最先触碰到的为支持向量

  4. 超平面的方程

    wTx+b=0\boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}+b=0

    其中:w\boldsymbol{w}和x\boldsymbol{x}都是n×1n\times 1的列向量,nn是特征维数。bb为标量;w\boldsymbol{w}还是超平面的法向量,bb控制了超平面到原点的距离。确定了w\boldsymbol{w}和bb,超平面就被完全确定了。

    那么在超平面上方数据wTx+b>0\boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}+b>0;在超平面下方数据wTx+b<0\boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}+b<0;

  5. wTx+b=0\boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}+b=0与ζwTx+ζb=0\zeta\boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}+\zeta b=0表示的是同一个超平面

    如:4x+4y=04x+4y=0 和 x+y=0x+y=0 是同一个平面,4x+4y=44x+4y=4 和 x+y=1x+y=1也是同一个平面

  6. 线性可分数据集的定义

    在数据集{(xi,yi)}i=1∼m\left\{ \left( \boldsymbol{x}_i,y_i \right) \right\} _{i=1\sim m}中,∃(w,b)\exists \left( \boldsymbol{w},b \right),使得对于∀i=1∼m\forall i=1 \sim m,有:

    {若yi=+1,则wTxi+b>0若yi=−1,则wTxi+b<0\begin{cases} \text{若}y_i=+1, \text{则}\boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}_{\boldsymbol{i}}+b> 0\\ \text{若}y_i=-1, \text{则}\boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}_{\boldsymbol{i}}+b< 0\\ \end{cases}

    即正样本全部分到上方,负样本全部分到下方

    等价于 yi(wTxi+b)>0y_i(\boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}_{\boldsymbol{i}}+b)> 0

  7. 点到平面距离公式

    点(x0,y0)(x_0,y_0)到平面w1x+w2y+b=0w_1x+w_2y+b=0的距离表示为:

    d=∣w1x0+w2y0+b∣w12+w22d=\frac{\left| w_1x_0+w_2y_0+b \right|}{\sqrt{w_{1}^{2}+w_{2}^{2}}}

    则样本点到超平面的距离表示为:

    d=∣wTxi+b∣∥w∥d=\frac{\left| \boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}_{\boldsymbol{i}}+b \right|}{\lVert \boldsymbol{w} \rVert}

  8. 若假设支持向量过超平面的平行线为wTx+b=1\boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}+b=1和wTx+b=−1\boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}+b=-1(如上图所示),那么可求得

    支持向量到超平面的距离为:

    d=1∥w∥d=\frac{1}{\lVert \boldsymbol{w} \rVert}

    那么超平面左右平移被限制的范围(即两个异类支持向量到超平面的距离之和)为:

    Υ=2∥w∥\varUpsilon =\frac{2}{\lVert \boldsymbol{w} \rVert}

    Υ\varUpsilon被称为SVM的“间隔”(margin)

    为什么可以假设支持向量过超平面的平行线为wTx+b=1\boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}+b=1和wTx+b=−1\boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}+b=-1呢?正如上面第5点所述,由于W\boldsymbol{W}和bb可以整体缩放倍数,超平面不变。那么总可以通过ζ⋅(w,b)→(w′,b′)\zeta \cdot \left( \boldsymbol{w},b \right) \rightarrow \left( \boldsymbol{w'},b' \right),使∣wTx+b∣=1\left| \boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}+b \right|=1。归一化的操作为我们带来便利

求解超平面转化为下列优化问题

在限制条件 yi(wTxi+b)⩾1,i=1∼my_i(w^Tx_i+b)\geqslant 1,i=1\sim m 下,最小化 12∥w∥2\frac{1}{2}\lVert \boldsymbol{w} \rVert ^2 的问题

即:

min⁡w,b  12∥w∥2s.t.yi(wTxi+b)⩾1,i=1∼m\begin{aligned} &\underset{\boldsymbol{w},b}{\min}\,\,\frac{1}{2}\lVert \boldsymbol{w} \rVert ^2 \\ &s.t.\quad y_i(\boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}_{\boldsymbol{i}}+b)\geqslant 1,i=1\sim m \end{aligned}

最大化Υ=2∥w∥\varUpsilon =\frac{2}{\lVert \boldsymbol{w} \rVert}等价于最小化12∥w∥2\frac{1}{2}\lVert \boldsymbol{w} \rVert ^2,而限制条件yi(wTxi+b)⩾1,i=1∼my_i(w^Tx_i+b)\geqslant 1,i=1\sim m表示求解超平面的前提条件是所有样本都被正确分类的情况下

这样就把支持向量机的求解转化为凸优化问题中的二次规划问题

二次规划(Quadratic Programming)

  1. 目标函数(Objective Function)为二次项
  2. 限制条件为一次项

要么无解,要么只有一个极值

SVM(非线性模型)数学推导

若数据集非线性可分,那么线性SVM的优化问题会变得无解。通过加入正则项,可以使SVM应用于非线性可分的数据集。

改写优化目标函数和限制条件

min⁡w,b  12∥w∥2+C∑i=1mξis.t.{yi(wTxi+b)⩾1−ξiξi⩾0,i=1∼m(1)\begin{aligned} &\underset{\boldsymbol{w},b}{\min}\,\,\frac{1}{2}\lVert \boldsymbol{w} \rVert ^2+C\sum_{i=1}^m{\xi _i}\\ &s.t.\quad \begin{cases} y_i\left( \boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}_{\boldsymbol{i}}+b \right) \geqslant 1-\xi _i\\ \xi _i\geqslant 0\\ \end{cases},i=1\sim m\\ \end{aligned} \tag{1}

其中:ξi\xi_i称为松弛变量(Slack Variable),∑i=1mξi\sum_{i=1}^m{\xi _i}称为正则项

若ξi\xi_i足够大,则限制条件可以被轻易满足(即为限制条件加入了容忍度)。但ξi\xi_i又不能太大,那么限制条件就失去了意义。因此在优化目标函数里需要添加ξi\xi_i,并用一个超参数CC来权衡最小化12∥w∥2\frac{1}{2}\lVert \boldsymbol{w} \rVert ^2与最小化∑i=1mξi\sum_{i=1}^m{\xi _i}之间的关系

低维到高维的映射

改写优化目标函数和限制条件后的SVM可以应用于非线性可分的数据集中。但是这样的SVM仍然是在试图寻找一条直线将正负样本划分,在某些情况下这仍然不够好,例如:
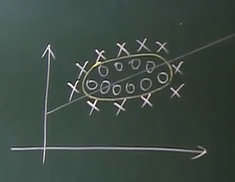
示意图

不同于其他机器学习算法,SVM试图通过高维映射,使低维空间的线性不可分问题变成高维空间中的线性可分问题,从而在高维空间中画出超平面对数据集进行划分。

我们定义高维映射φ(x)\varphi (\boldsymbol{x}):

x→φφ(x)\boldsymbol{x}\xrightarrow{\varphi }\varphi \left( \boldsymbol{x} \right)

其中x\boldsymbol{x}是低维向量,而φ(x)\varphi (\boldsymbol{x})为高维向量

那么SVM的优化条件变为:

min⁡w,b  12∥w∥2+C∑i=1mξis.t.{yi(wTφ(xi)+b)⩾1−ξiξi⩾0,i=1∼m\begin{aligned} &\underset{\boldsymbol{w},b}{\min}\,\,\frac{1}{2}\lVert \boldsymbol{w} \rVert ^2 +C\sum_{i=1}^m{\xi _i} \\ &s.t.\quad \begin{cases} y_i(\boldsymbol{w}^{\boldsymbol{T}}\varphi (\boldsymbol{x}_{\boldsymbol{i}})+b) \geqslant 1-\xi _i\\ \xi _i\geqslant 0\\ \end{cases},i=1\sim m \end{aligned}

此时w\boldsymbol{w}的维度也升高了,与φ(x)\varphi (\boldsymbol{x})的维度相同

例子:

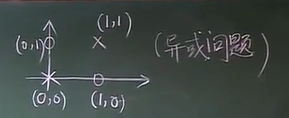
示意图

对于这么一个异或问题,我们有:

x1=[00]∈C1,x2=[11]∈C1,x3=[10]∈C2,x4=[01]∈C2\begin{aligned} &\boldsymbol{x}_{\boldsymbol{1}}=\left[ \begin{array}{c} 0\\ 0\\ \end{array} \right] \in C_1,\quad \boldsymbol{x}_{\boldsymbol{2}}=\left[ \begin{array}{c} 1\\ 1\\ \end{array} \right] \in C_1,\quad \\ &\boldsymbol{x}_{\boldsymbol{3}}=\left[ \begin{array}{c} 1\\ 0\\ \end{array} \right] \in C_2,\quad \boldsymbol{x}_{\boldsymbol{4}}=\left[ \begin{array}{c} 0\\ 1\\ \end{array} \right] \in C_2 \end{aligned}

定义映射关系:

x=[ab]→φφ(x)=[a2b2abab]\boldsymbol{x}=\left[ \begin{array}{c} a\\ b\\ \end{array} \right] \xrightarrow{\varphi }\varphi \left( \boldsymbol{x} \right) =\left[ \begin{array}{c} a^2\\ b^2\\ a\\ \begin{array}{c} b\\ ab\\ \end{array}\\ \end{array} \right]

则升维后的样本为

φ(x1)=[00000]∈C1,φ(x2)=[11111]∈C1,φ(x3)=[10100]∈C2,φ(x4)=[01010]∈C2\begin{aligned} &\varphi \left( \boldsymbol{x}_{\boldsymbol{1}} \right) =\left[ \begin{array}{c} \begin{array}{c} 0\\ 0\\ \end{array}\\ \begin{array}{c} 0\\ 0\\ 0\\ \end{array}\\ \end{array} \right] \in C_1,\quad \varphi \left( \boldsymbol{x}_{\boldsymbol{2}} \right) =\left[ \begin{array}{c} \begin{array}{c} 1\\ 1\\ \end{array}\\ \begin{array}{c} 1\\ 1\\ 1\\ \end{array}\\ \end{array} \right] \in C_1,\quad \\ &\varphi \left( \boldsymbol{x}_{\boldsymbol{3}} \right) =\left[ \begin{array}{c} \begin{array}{c} 1\\ 0\\ \end{array}\\ \begin{array}{c} 1\\ 0\\ 0\\ \end{array}\\ \end{array} \right] \in C_2,\quad \varphi \left( \boldsymbol{x}_{\boldsymbol{4}} \right) =\left[ \begin{array}{c} \begin{array}{c} 0\\ 1\\ \end{array}\\ \begin{array}{c} 0\\ 1\\ 0\\ \end{array}\\ \end{array} \right] \in C_2 \end{aligned}

求得w\boldsymbol{w}为:

w=[−1−1−1−16],b=1\boldsymbol{w}=\left[ \begin{array}{c} \begin{array}{c} -1\\ -1\\ \end{array}\\ \begin{array}{c} -1\\ -1\\ 6\\ \end{array}\\ \end{array} \right] ,\quad b=1

则

y^1=wTx1+b  =  1>0y^2=wTx2+b  =  3>0y^3=wTx3+b  =  −1<0y^4=wTx4+b  =  −1<0\begin{aligned} \widehat{y}_1&=\boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}_{\boldsymbol{1}}+b\,\,=\,\,1>0\\\widehat{y}_2&=\boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}_{\boldsymbol{2}}+b\,\,=\,\,3>0\\\widehat{y}_3&=\boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}_{\boldsymbol{3}}+b\,\,=\,\,-1<0\\\widehat{y}_4&=\boldsymbol{w}^{\boldsymbol{T}}\boldsymbol{x}_{\boldsymbol{4}}+b\,\,=\,\,-1<0 \end{aligned}

可见的确通过升维,在高维空间划分了超平面,实现了非线性可分数据的分类问题。

核函数

可以证明:若升的维度越高,则数据集越有可能在高维空间被线性划分。可以猜想,若φ(x)\varphi (\boldsymbol{x})为无限维度,则必定可以在无限高维空间划分任意数据集。但这样,会使得w\boldsymbol{w}也变为无限维度,使优化问题(1)(1)变得不可解(因为w\boldsymbol{w}是代求参数)。

定理:我们可以不知道无限维映射φ(x)\varphi (\boldsymbol{x})的显式表达,我们只要知道一个核函数(Kernel Function)

K(x1,x2)  =  φ(x1)T⋅φ(x2)K\left( \boldsymbol{x}_{\boldsymbol{1}},\boldsymbol{x}_{\boldsymbol{2}} \right) \,\,=\,\,\varphi \left( \boldsymbol{x}_{\boldsymbol{1}} \right) ^T\cdot \varphi \left( \boldsymbol{x}_{\boldsymbol{2}} \right)

则(1)(1)这个优化式仍然可解。

常用核函数:

  1. 高斯核

    K(x1,x2)  =  e−∥x1−x2∥22σ2K\left( \boldsymbol{x}_{\boldsymbol{1}},\boldsymbol{x}_{\boldsymbol{2}} \right) \,\,=\,\,e^{-\frac{\lVert x_1-x_2 \rVert ^2}{2\sigma ^2}}

  2. 多项式核

K(x1,x2)  =  (x1Tx2+1)dK\left( \boldsymbol{x}_{\boldsymbol{1}},\boldsymbol{x}_{\boldsymbol{2}} \right) \,\,=\,\,\left( \boldsymbol{x}_{\boldsymbol{1}}^{\boldsymbol{T}}\boldsymbol{x}_{\boldsymbol{2}}+1 \right) ^d

我们知道核K(x1,x2)K\left( \boldsymbol{x}_{\boldsymbol{1}},\boldsymbol{x}_{\boldsymbol{2}} \right)的表达式,且知道K(x1,x2)K\left( \boldsymbol{x}_{\boldsymbol{1}},\boldsymbol{x}_{\boldsymbol{2}} \right)可以表示为φ(x1)Tφ(x2)\varphi \left( \boldsymbol{x}_{\boldsymbol{1}} \right) ^T \varphi \left( \boldsymbol{x}_{\boldsymbol{2}} \right),并且φ(x)\varphi (\boldsymbol{x})是无限维的(不需要知道φ(x)\varphi (\boldsymbol{x})的显示表达)。

K(x1,x2)K\left( \boldsymbol{x}_{\boldsymbol{1}},\boldsymbol{x}_{\boldsymbol{2}} \right)能写成φ(x1)Tφ(x2)\varphi \left( \boldsymbol{x}_{\boldsymbol{1}} \right) ^T \varphi \left( \boldsymbol{x}_{\boldsymbol{2}} \right)的充要条件为(Mercer’s Theorem):

  1. K(x1,x2)=K(x2,x1)K\left( \boldsymbol{x}_{\boldsymbol{1}},\boldsymbol{x}_{\boldsymbol{2}} \right) = K\left( \boldsymbol{x}_{\boldsymbol{2}},\boldsymbol{x}_{\boldsymbol{1}} \right)(交换性)
  2. ∀Ci,  xi(i=1∼N)\forall C_i, \,\, \boldsymbol{x_i}(i=1\sim N),有∑i=1N∑j=1NCiCjK(x1,x2)⩾0  \sum_{i=1}^N{\sum_{j=1}^N{C_iC_jK\left( \boldsymbol{x}_{\boldsymbol{1}},\boldsymbol{x}_{\boldsymbol{2}} \right) \geqslant 0}}\,\,成立(半正定性)

原问题和对偶问题

现在我们要在只知道K(x1,x2)K\left( \boldsymbol{x}_{\boldsymbol{1}},\boldsymbol{x}_{\boldsymbol{2}} \right)不知道φ(x)\varphi (\boldsymbol{x})的情况下,解优化问题(1)(1),因此我们需要一些理论知识铺垫。

这是优化理论的内容,用到就学一下吧

原问题(Prime Problem):

最小化:

f(ω)f(\boldsymbol{\omega})

限制条件:

gi(ω)⩽0(i=1∼K)hi(ω)=0(i=1∼M)\begin{array}{cc} g_i\left( \boldsymbol{\omega} \right) \leqslant 0 \left( i=1\sim K \right) \\ h_i\left( \boldsymbol{\omega} \right) =0 \left( i=1\sim M \right) \end{array}

则其对偶问题(Dual Problem)为:

最大化:

Θ(α,β)  =  inffor  all  ω{L(ω,α,β)}\varTheta \left( \boldsymbol{\alpha} ,\boldsymbol{\beta}\right) \,\,=\,\,\underset{for\,\,all\,\,\boldsymbol{\omega}}{inf}\left\{ L\left( \boldsymbol{\omega} ,\boldsymbol{\alpha} ,\boldsymbol{\beta} \right) \right\}

限制条件:

α⩾0\boldsymbol{\alpha }\geqslant 0

其中L(ω,α,β)L\left( \boldsymbol{\omega} ,\boldsymbol{\alpha },\boldsymbol{\beta } \right)为:

L(ω,α,β)  =  f(ω)+∑i=1Kαigi(ω)+∑i=1Mβihi(ω)  =  f(ω)+αTg(ω)+βTh(ω)\begin{aligned} L\left( \boldsymbol{\omega} ,\boldsymbol{\alpha },\boldsymbol{\beta } \right) \,\,&=\,\,f\left( \boldsymbol{\omega} \right) +\sum_{i=1}^K{\alpha _ig_i\left( \boldsymbol{\omega} \right)}+\sum_{i=1}^M{\beta _ih_i\left( \boldsymbol{\boldsymbol{\omega}} \right)}\,\, \\ &=\,\,f\left( \boldsymbol{\omega} \right) +\boldsymbol{\alpha }^{\boldsymbol{T}}g\left( \boldsymbol{\omega} \right) +\boldsymbol{\beta }^{\boldsymbol{T}}h\left( \boldsymbol{\omega} \right) \end{aligned}

inffor  all  ω\underset{for\,\,all\,\,\boldsymbol{\omega}}{inf}的意思是,在所有ω\boldsymbol{\omega}取值上取得的最小值

原问题和对偶问题的关系:如果ω∗\boldsymbol{\omega}^*是原问题的解,而α∗,β∗\boldsymbol{\alpha}^*,\boldsymbol{\beta}^*是对偶问题的解,则有:

f(ω∗)⩾θ(α∗,β∗)f\left( \boldsymbol{\omega} ^* \right) \geqslant \theta \left( \boldsymbol{\alpha} ^*,\boldsymbol{\beta} ^* \right)

proof:

θ(α∗,β∗)  =  inffor  all  ω{L(ω,α∗,β∗)}⩽L(ω∗,α∗,β∗)=  f(ω∗)+∑i=1Kαi∗gi(ω∗)+∑i=1Mβi∗hi(ω∗)⩽  f(ω∗)\begin{aligned} \theta \left( \boldsymbol{\alpha }^*,\boldsymbol{\beta }^* \right) \,\,&=\,\,\underset{for\,\,all\,\,\omega}{inf}\left\{ L\left( \boldsymbol{\omega },\boldsymbol{\alpha }^*,\boldsymbol{\beta }^* \right) \right\} \leqslant L\left( \boldsymbol{\omega }^*,\boldsymbol{\alpha }^*,\boldsymbol{\beta }^* \right) \\ &=\,\,f\left( \boldsymbol{\omega }^* \right) +\sum_{i=1}^K{\boldsymbol{\alpha }_{i}^{*}g_i\left( \boldsymbol{\omega }^* \right)}+\sum_{i=1}^M{\boldsymbol{\beta }_{i}^{*}h_i\left( \boldsymbol{\omega }^* \right)}\leqslant \,\,f\left( \boldsymbol{\omega }^* \right) \end{aligned}

因为其中α∗⩾0\boldsymbol{\alpha^* }\geqslant 0, gi(ω∗)⩽0g_i\left( \boldsymbol{\omega ^*} \right) \leqslant 0,hi(ω∗)=0h_i\left( \boldsymbol{\omega^* } \right) =0

强对偶定理

若f(ω)f(\boldsymbol{\omega})为凸函数,且g(ω)=Aω+bg(\boldsymbol{\omega}) = \boldsymbol{A\omega} + b,h(ω)=Cω+dh(\boldsymbol{\omega}) = \boldsymbol{C\omega} + d,则优化问题的原问题与对偶问题间距为0,即:

f(ω∗)=θ(α∗,β∗)f\left( \boldsymbol{\omega} ^* \right) = \theta \left( \boldsymbol{\alpha} ^*,\boldsymbol{\beta} ^* \right)

再观察上面的proof过程,可以立即得出:

对 ∀i=1∼K\forall i=1 \sim K,有αi∗=0\boldsymbol{\alpha^*_i }=0 或者 gi(ω∗)=0g_i\left( \boldsymbol{\omega ^*} \right) =0

以上称为KKT条件

将SVM原问题转化为对偶问题

核函数SVM优化目标可以改写为(为了使形式上靠近优化理论,将ξi⩾0→ξi⩽0\xi _i\geqslant 0\rightarrow \xi _i\leqslant 0)

最小化:

min⁡w,b  12∥w∥2+C∑i=1mξi→min⁡w,b  12∥w∥2−C∑i=1mξi\underset{\boldsymbol{w},b}{\min}\,\,\frac{1}{2}\lVert \boldsymbol{w} \rVert ^2+C\sum_{i=1}^m{\xi _i}\rightarrow \underset{\boldsymbol{w},b}{\min}\,\,\frac{1}{2}\lVert \boldsymbol{w} \rVert ^2-C\sum_{i=1}^m{\xi _i}

限制条件:

yi(wTφ(xi)+b)⩾1−ξi  →  yi(wTφ(xi)+b)⩾1+ξi  →  1+ξi−yi(wTφ(xi)+b)⩽0ξi⩾0→ξi⩽0\begin{aligned} y_i\left( \boldsymbol{w}^{\boldsymbol{T}}\varphi \boldsymbol{(x}_{\boldsymbol{i}}\text{)}+b \right) \geqslant 1-\xi _i\,\,&\rightarrow \,\,y_i\left( \boldsymbol{w}^{\boldsymbol{T}}\varphi \boldsymbol{(x}_{\boldsymbol{i}}\text{)}+b \right) \geqslant 1+\xi _i\,\, \\ &\rightarrow \,\,1+\xi _i-y_i\left( \boldsymbol{w}^{\boldsymbol{T}}\varphi \boldsymbol{(x}_{\boldsymbol{i}}\text{)}+b \right) \leqslant 0 \\ \xi _i\geqslant 0&\rightarrow \xi _i\leqslant 0 \end{aligned}

1. 原问题 1.核函数SVM原问题
最小化:
f(ω)f(\boldsymbol{\omega})
最小化:
12∥w∥2−C∑i=1mξi\frac{1}{2}\lVert \boldsymbol{w} \rVert ^2-C\sum_{i=1}^m{\xi _i}
限制条件:
gi(ω)⩽0(i=1∼K)hi(ω)=0(i=1∼M)\begin{array}{cc} g_i\left( \boldsymbol{\omega} \right) \leqslant 0 \left( i=1\sim K \right) \\h_i\left( \boldsymbol{\omega} \right) =0 \left( i=1\sim M \right) \end{array}
限制条件:
 1+ξi−yi(wTφ(xi)+b)⩽0ξi⩽0\begin{array}{cc} \,1+\xi _i-y_i\left( \boldsymbol{w}^{\boldsymbol{T}}\varphi \boldsymbol{(x}_{\boldsymbol{i}}\text{)}+b \right) \leqslant 0 \\ \xi _i\leqslant 0 \end{array}

从限制条件可知,左边的不等式限制条件gi(ω)⩽0g_i\left( \boldsymbol{\omega} \right) \leqslant 0对应右边的 1+ξi−yi(wTφ(xi)+b)⩽0\,1+\xi _i-y_i\left( \boldsymbol{w}^{\boldsymbol{T}}\varphi \boldsymbol{(x}_{\boldsymbol{i}}\text{)}+b \right) \leqslant 0和ξi⩽0\xi _i\leqslant 0;而没有等式限制条。

优化目标函数f(ω)f(\boldsymbol{\omega})对应12∥w∥2+C∑i=1mξi\frac{1}{2}\lVert \boldsymbol{w} \rVert ^2+C\sum_{i=1}^m{\xi _i}

左边只有一个变量ω\boldsymbol{\omega},而右边对应有三个变量ω,ξi,b\boldsymbol{\omega},\xi _i, b

因此可以推导出核函数SVM的对偶问题:

2. 对偶问题 2. 核函数SVM对偶问题
最大化:
Θ(α,β) = inffor  all  ω{L(ω,α,β)}\varTheta \left( \boldsymbol{\alpha} ,\boldsymbol{\beta}\right) \,=\,\underset{for\,\,all\,\,\boldsymbol{\omega}}{inf}\left\{ L\left( \boldsymbol{\omega} ,\boldsymbol{\alpha} ,\boldsymbol{\beta} \right) \right\}
最大化:
Θ(α,β) = inffor  all ( ω,ξi,b){12∥w∥2−C∑i=1mξi+∑i=1mαi (1+ξi−yi(wTφ(xi)+b))+∑i=1mβiξi}\begin{aligned}\varTheta\left(\boldsymbol{\alpha },\boldsymbol{\beta}\right)\,=\,\underset{for\,\,all\,\left(\,\boldsymbol{\omega},\xi_i,b\right)}{inf}\left\{\frac{1}{2}\lVert\boldsymbol{w}\rVert^2-C\sum_{i=1}^m{\xi_i}+\sum_{i=1}^m{\alpha_i}\,\left(1+\xi_i-y_i\left(\boldsymbol{w}^{\boldsymbol{T}}\varphi\boldsymbol{(x}_{\boldsymbol{i}}\text{)}+b\right)\right)+\sum_{i=1}^m{\beta_i\xi_i}\right\}\end{aligned}
限制条件:
αi⩾0(i=1∼K)\alpha_i\geqslant 0 \quad (i=1 \sim K)
限制条件:
αi⩾0,βi⩾0(i=1∼m)\alpha_i\geqslant 0 , \beta_i \geqslant 0 \quad(i=1 \sim m)
L(ω,α,β)  =  f(ω)+∑i=1Kαigi(ω)+∑i=1Mβihi(ω)  L\left( \boldsymbol{\omega },\boldsymbol{\alpha },\boldsymbol{\beta } \right) \,\,=\,\,f\left( \boldsymbol{\omega } \right) +\sum_{i=1}^K{\alpha _ig_i\left( \boldsymbol{\omega } \right)}+\sum_{i=1}^M{\beta _ih_i\left( \boldsymbol{\omega } \right)}\,\,

注意,由于SVM中的不等式限制条件有αi\alpha_i和βi\beta_i两个,因此实际上左边的αi\alpha_i对应右边的αi\alpha_i和βi\beta_i

现在我们来求解下式的具体表达式

Θ(α,β) =inffor  all ( ω,ξi,b){L(ω,ξ,b)} =inffor  all ( ω,ξ,b){12∥w∥2−C∑i=1mξi+∑i=1mαi (1+ξi−yi(wTφ(xi)+b))+∑i=1mβiξi}\begin{aligned} \varTheta \left( \boldsymbol{\alpha },\boldsymbol{\beta } \right) \,&=\underset{for\,\,all\,\left( \,\boldsymbol{\omega },\xi _i,b \right)}{inf}\left\{ L\left( \boldsymbol{\omega },\boldsymbol{\xi },b \right) \right\} \, \\ &=\underset{for\,\,all\,\left( \,\boldsymbol{\omega },\boldsymbol{\xi },b \right)}{inf}\left\{ \frac{1}{2}\lVert \boldsymbol{w} \rVert ^2-C\sum_{i=1}^m{\xi _i}+\sum_{i=1}^m{\alpha _i}\,\left( 1+\xi _i-y_i\left( \boldsymbol{w}^{\boldsymbol{T}}\varphi \boldsymbol{(x}_{\boldsymbol{i}}\text{)}+b \right) \right) +\sum_{i=1}^m{\beta _i\xi _i} \right\} \end{aligned}

inffor  all ( ω,ξi,b)\underset{for\,\,all\,\left( \,\boldsymbol{\omega },\xi _i,b \right)}{inf}表示求关于( ω,ξi,b)\left( \,\boldsymbol{\omega },\xi _i,b \right)的最小值,即求∂∂ωL(ω,ξi,b)\frac{\partial}{\partial \boldsymbol{\omega }}L\left( \boldsymbol{\omega },\xi _i,b \right),∂∂ξiL(ω,ξi,b)\frac{\partial}{\partial \xi _i}L\left( \boldsymbol{\omega },\xi _i,b \right),∂∂bL(ω,ξi,b)\frac{\partial}{\partial b}L\left( \boldsymbol{\omega },\xi _i,b \right),并使他们等于零:

∂∂ωL(ω,ξi,b)=0→ω=∑i=1mαiyiφ(xi)∂∂ξiL(ω,ξi,b)=0→αi+βi=C∂∂bL(ω,ξi,b)=0→∑i=1mαiyi=0(2)\begin{aligned} &\frac{\partial}{\partial \boldsymbol{\omega }}L\left( \boldsymbol{\omega },\xi _i,b \right) =0\rightarrow \boldsymbol{\omega }=\sum_{i=1}^m{\alpha _iy_i\varphi \left( x_i \right)}\\ &\frac{\partial}{\partial \xi _i}L\left( \boldsymbol{\omega },\xi _i,b \right) =0\rightarrow \alpha _i+\beta _i=C\\ &\frac{\partial}{\partial b}L\left( \boldsymbol{\omega },\xi _i,b \right) =0\rightarrow \sum_{i=1}^m{\alpha _iy_i=0}\\ \end{aligned} \tag2

其中用到矩阵求导参考矩阵论,这里给出结果

若f(ω)=12∥ω∥2f\left( \boldsymbol{\omega } \right) =\frac{1}{2}\lVert \boldsymbol{\omega } \rVert ^2,则∂∂ωf(ω)=ω\frac{\partial}{\partial \boldsymbol{\omega }}f\left( \boldsymbol{\omega } \right) =\boldsymbol{\omega }

若f(ω)=ωTxf\left( \boldsymbol{\omega } \right) =\boldsymbol{\omega }^{\text{T}}x,则∂∂ωf(ω)=x\frac{\partial}{\partial \boldsymbol{\omega }}f\left( \boldsymbol{\omega } \right) =x

将(2)(2)带入Θ(α,β)\varTheta \left( \boldsymbol{\alpha },\boldsymbol{\beta } \right),得到:

Θ(α)=∑i=1mαi−12∑i=1m∑j=1mαiαjyiyjK(xi,xj)\varTheta \left( \boldsymbol{\alpha }\right) =\sum_{i=1}^m{\alpha _i-\frac{1}{2}\sum_{i=1}^m{\sum_{j=1}^m{\alpha _i\alpha _jy_iy_j}}}K\left( x_i,x_j \right)

这时,通过把原问题转换为对偶问题,得到了核函数的表示形式!

将(2)(2)带入限制条件αi⩾0,βi⩾0(i=1∼m)\alpha_i\geqslant 0 , \beta_i \geqslant 0 (i=1 \sim m)得到:

0⩽αi⩽C∑i=1mαiyi=0\begin{array}{cc} 0\leqslant \alpha _i\leqslant C \\ \sum_{i=1}^m{\alpha _iy_i=0} \end{array}

于是我们求得了核函数SVM的优化对偶问题

核函数SVM对偶问题
最大化:Θ(α)=∑i=1mαi−12∑i=1m∑j=1mαiαjyiyjK(xi,xj)\varTheta \left( \boldsymbol{\alpha }\right) =\sum_{i=1}^m{\alpha _i-\frac{1}{2}\sum_{i=1}^m{\sum_{j=1}^m{\alpha _i\alpha _jy_iy_j}}}K\left( x_i,x_j \right)
限制条件:0⩽αi⩽C∑i=1mαiyi=00\leqslant \alpha _i\leqslant C \quad\quad \sum_{i=1}^m{\alpha _iy_i=0}

于是只有一个参数待求解:α\boldsymbol{\alpha},通常可以使用SMO算法

在测试流程中,我们可以有如下判断:

{若wTφ(xi)+b>0,则yi=+1若wTφ(xi)+b<0,则yi=−1\begin{cases} \text{若}\boldsymbol{w}^{\boldsymbol{T}}\varphi \left( \boldsymbol{x}_{\text{i}} \right) +b>0,\text{则}y_{\text{i}}=+1\\ \text{若}\boldsymbol{w}^{\boldsymbol{T}}\varphi \left( \boldsymbol{x}_{\text{i}} \right) +b<0,\text{则}y_{\text{i}}=-1\\ \end{cases}

在(2)(2)中,我们知道有ω=∑i=1mαiyiφ(xi)\boldsymbol{\omega }=\sum_{i=1}^m{\alpha _iy_i\varphi \left( \boldsymbol{x_i} \right)},则:

wTφ(xi)=∑j=1m[αiyiφ(xj)]Tφ(xi)=∑j=1mαiyiφ(xj)Tφ(xi)=∑j=1mαiyiK(xi,xj)(3)\begin{aligned} \boldsymbol{w}^{\boldsymbol{T}}\varphi \left( \boldsymbol{x}_{\boldsymbol{i}} \right) &=\sum_{j=1}^m{\left[ \alpha _iy_i\varphi \left( \boldsymbol{x}_j \right) \right] ^{\text{T}}}\varphi \left( \boldsymbol{x}_{\boldsymbol{i}} \right) \\&=\sum_{j=1}^m{\alpha _iy_i\varphi \left( \boldsymbol{x}_{\boldsymbol{j}} \right) ^{\text{T}}\varphi \left( \boldsymbol{x}_{\boldsymbol{i}} \right)}\\&=\sum_{j=1}^m{\alpha _iy_iK\left( \boldsymbol{x}_{\boldsymbol{i}},\boldsymbol{x}_{\boldsymbol{j}} \right)} \end{aligned} \tag{3}

只剩下bb待求解。确定了bb,则核函数SVM训练完成

bb的求解需要用到KKT条件,

3. KKT条件 3. SVM的KKT条件
∀i=1∼K\forall i=1 \sim K,
αi∗=0\boldsymbol{\alpha^*_i }=0 或者 gi(ω∗)=0g_i\left( \boldsymbol{\omega ^*} \right) =0
∀i=1∼m\forall i=1 \sim m,
1. αi=0\boldsymbol{\alpha_i }=0 或者  1+ξi−yi(wTφ(xi)+b)=0\,1+\xi _i-y_i\left( \boldsymbol{w}^{\boldsymbol{T}}\varphi \boldsymbol{(x}_{\boldsymbol{i}}\text{)}+b \right) = 0
2. βi=0\boldsymbol{\beta_i }=0或者ξi=0\xi_i=0

取一个0<αi<C⇒βi=C−αi>00<\boldsymbol{\alpha }_{\boldsymbol{i}}<C\Rightarrow \boldsymbol{\beta }_{\boldsymbol{i}}=C-\boldsymbol{\alpha }_{\boldsymbol{i}}>0,此时有:

βi≠0⇒ξi=0αi≠0⇒1+ξi−yi(wTφ(xi)+b)=0⇒1−yi(wTφ(xi)+b)=0\begin{aligned} \boldsymbol{\beta }_{\boldsymbol{i}}\ne 0&\Rightarrow \xi _i=0 \\ \boldsymbol{\alpha }_{\boldsymbol{i}}\ne 0&\Rightarrow 1+\xi _i-y_i\left( \boldsymbol{w}^{\boldsymbol{T}}\varphi \boldsymbol{(x}_{\boldsymbol{i}}\text{)}+b \right) =0 \\ &\Rightarrow 1-y_i\left( \boldsymbol{w}^{\boldsymbol{T}}\varphi \boldsymbol{(x}_{\boldsymbol{i}}\text{)}+b \right) =0 \end{aligned}

带入(3)(3),得到:

b=1yi−wTφ(xi)=1−yiwTφ(xi)yi=1−yi∑j=1mαiyiK(xi,xj)yi\begin{aligned} b&=\frac{1}{y_i}-\boldsymbol{w}^{\boldsymbol{T}}\varphi \boldsymbol{(x}_{\boldsymbol{i}}\text{)}=\frac{1-y_i\boldsymbol{w}^{\boldsymbol{T}}\varphi \boldsymbol{(x}_{\boldsymbol{i}}\text{)}}{y_i} \\ &=\frac{1-y_i\sum_{j=1}^m{\alpha _iy_iK\left( \boldsymbol{x}_{\boldsymbol{i}},\boldsymbol{x}_{\boldsymbol{j}} \right)}}{y_i} \end{aligned}

以上就是核函数SVM原问题转换为对偶问题,并用对偶问题训练SVM(求出αi\boldsymbol{\alpha_i}和bb的过程)的推导过程

核函数SVM算法总结

SVM算法

  1. 训练流程:

    • 输入(xi,yi)i=1∼m{(\boldsymbol{x_i},y_i)}_{i=1 \sim m}

    • 解优化问题:

      ​ 最大化:Θ(α)=∑i=1mαi−12∑i=1m∑j=1mαiαjyiyjK(xi,xj)\varTheta \left( \boldsymbol{\alpha }\right) =\sum_{i=1}^m{\alpha _i-\frac{1}{2}\sum_{i=1}^m{\sum_{j=1}^m{\alpha _i\alpha _jy_iy_j}}}K\left( x_i,x_j \right)

      ​ 限制条件:0⩽αi⩽C,∑i=1mαiyi=00\leqslant \alpha _i\leqslant C, \quad\sum_{i=1}^m{\alpha _iy_i=0}

      ​ 求解bb:找一个0<αi<C0<\boldsymbol{\alpha }_{\boldsymbol{i}}<C,可以算得b=1−yi∑j=1mαiyiK(xi,xj)yib=\frac{1-y_i\sum_{j=1}^m{\alpha _iy_iK\left( \boldsymbol{x}_{\boldsymbol{i}},\boldsymbol{x}_{\boldsymbol{j}} \right)}}{y_i}

  2. 测试流程

    • 输入测试样本x\boldsymbol{x}

      {若∑j=1mαiyiK(xi,xj)+b>0,则yi=+1若∑j=1mαiyiK(xi,xj)+b<0,则yi=−1\begin{cases} \text{若}\sum_{j=1}^m\alpha _iy_iK\left( \boldsymbol{x}_{\boldsymbol{i}},\boldsymbol{x}_{\boldsymbol{j}} \right) +b>0,\text{则}y_{\text{i}}=+1\\ \text{若}\sum_{j=1}^m\alpha _iy_iK\left( \boldsymbol{x}_{\boldsymbol{i}},\boldsymbol{x}_{\boldsymbol{j}} \right) +b<0,\text{则}y_{\text{i}}=-1\\ \end{cases}

通过转换为对偶问题,我们可以看到上面没有出现φ(x)\varphi (\boldsymbol{x}),而待求解的参数只有αi\boldsymbol{\alpha_i}和bb

SVM处理多分类问题

上面都在说如何用SVM处理二分类问题,那么怎么样用SVM处理多分类问题呢?

我们有一下三种方法:

  1. 改造优化的目标函数和限制条件,使之能处理多分类问题。

    这种方法通常效果一般,SVM专为二分类而生

  2. 一类VS其他类

    例子:

    若有C1,C2,C3C_1 ,C_2 ,C_3三类,则可以设计三个SVM

    SVM1:(C1,C2)VS(C3)(C_1 ,C_2)VS(C_3)

    SVM2:(C1,C3)VS(C2)(C_1 ,C_3)VS(C_2)

    SVM3:(C2,C3)VS(C1)(C_2 ,C_3)VS(C_1)

    若y1=+1,y2=+1,y3=−1y_1=+1,y_2=+1,y_3=-1,则 显然为第一类

    若y1=+1,y2=−1,y3=−1y_1=+1,y_2=-1,y_3=-1,在看看SVM1和SVM2的wTφ(xi)+b\boldsymbol{w}^{\boldsymbol{T}}\varphi \left( \boldsymbol{x}_{\text{i}} \right) +b哪一个负的比较多就判断为哪一个

  3. 一类VS另一类

    例子:

    若有C1,C2,C3C_1 ,C_2 ,C_3三类,则可以设计三个SVM

    SVM1:(C1)VS(C2)(C_1 )VS(C_2)

    SVM2:(C1)VS(C3)(C_1 )VS(C_3)

    SVM3:(C2)VS(C3)(C_2)VS(C_3)

    若y1=+1,y2=+1,y3=−1y_1=+1,y_2=+1,y_3=-1,则 显然为第一类(C1C_1被投了两票,C3C_3被投了一票)

对于n分类问题:

用一类VS其他类我们需要用n个SVM;

用一类VS另一类我们需要用n(n−1)2\frac{n\left( n-1 \right)}{2}个SVM。

根据经验,用一类VS另一类的效果最佳,但同时也是最复杂的。